Создано искусственным интеллектомУлучшено людьми
Riqli · живые документы · обновляются постоянно
Где знания об искусственном интеллекте встречаются с человеческой практикой.
Поделиться с друзьями
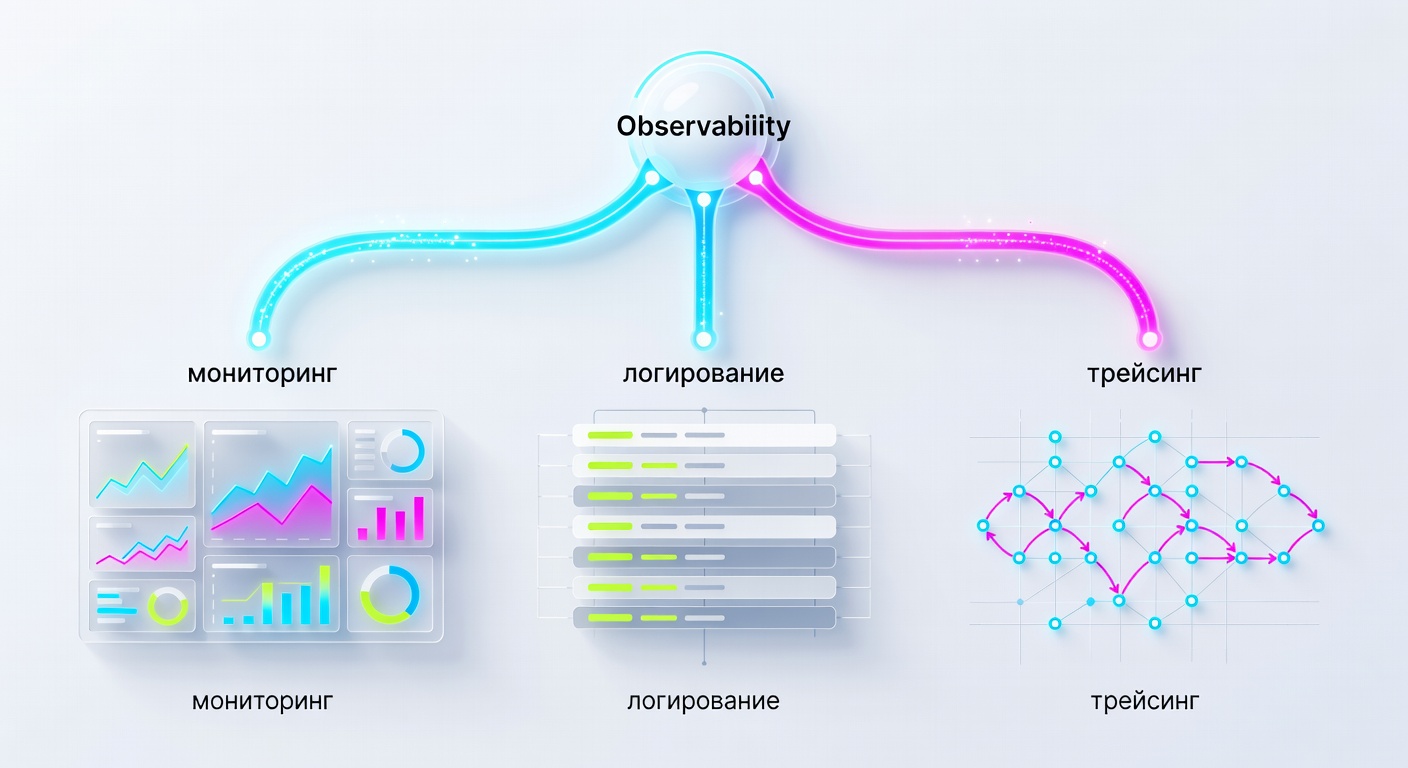
Observability: мониторинг, логирование, трейсинг. Hard skill. (Observability микросервисы. Мониторинг логирование трейсинг. Система observability. Prometheus grafana мониторинг. Tutorial. Practice. Standard.)
Observability: мониторинг, логирование, трейсинг
Введение в концепцию наблюдаемости IT-систем.
Наблюдаемость (Observability) — это способность понять внутреннее состояние системы по внешним данным (метрикам, логам, трейсам). Позволяет отвечать на вопрос «Почему система работает так, а не иначе?».
Три столпа наблюдаемости: мониторинг (что происходит?), логирование (что именно произошло?) и трейсинг (как запрос проходит через сервисы?).
Мониторинг: метрики и системы сбора данных
Глубокое погружение в мониторинг, его задачи, подходы и популярные инструменты.
Мониторинг решает задачи: контроль состояния системы (доступности), отслеживание производительности, прогнозирование роста нагрузки и обнаружение аномалий.
Белый ящик (White-box) и черный ящик (Black-box) — два подхода в мониторинге. Черный ящик проверяет систему извне (доступен ли сайт?). Белый ящик анализирует внутренние метрики (загрузка CPU, количество ошибок в коде).
Zabbix: классическая система мониторинга
Обзор архитектуры, агентов, сбора данных и алертинга в Zabbix.
Zabbix — зрелая система мониторинга с архитектурой «все в одном»: сбор метрик, визуализация, алертинг и логирование из коробки. Использует реляционные базы данных (PostgreSQL, MySQL).
Zabbix agent работает в двух режимах: активном (агент сам отправляет метрики серверу) и пассивном (сервер опрашивает агента). Активный режим безопаснее и экономит ресурсы.
Prometheus: современный мониторинг для микросервисов
Pull-модель, экспортеры, метрики и интеграция с Grafana.
Prometheus — система мониторинга, использующая pull-модель сбора метрик (сервер сам опрашивает экспортеры). Хранит данные в собственной time-series database. Оптимален для микросервисной архитектуры и Kubernetes.
Типы метрик Prometheus: Counter (счетчик, только увеличивается), Gauge (текущее значение, может расти и падать), Histogram (распределение значений по корзинам), Summary (квантили).
Логирование: от классического Linux до централизованных систем
Управление логами, journald, rsyslog, централизованные системы (ELK, Grafana Loki).
Классическое логирование в Linux — это текстовые файлы (обычно в /var/log/). Rsyslog — сервис для централизованного сбора логов, поддерживающий фильтрацию по facility и severity. Journald — бинарный журнал systemd.
Централизованное логирование решает проблему разрозненных логов. Логи собираются агентами (Filebeat, Vector), передаются в агрегатор (Logstash), а затем хранятся в Elasticsearch или Grafana Loki для поиска и анализа.
Распределенный трейсинг (Distributed Tracing)
Отслеживание запросов в микросервисных архитектурах.
Распределенный трейсинг необходим для микросервисной архитектуры. Он позволяет отследить путь одного запроса через десятки сервисов, увидеть задержки на каждом этапе и найти «узкое горлышко» производительности.
Ключевые понятия трейсинга: Trace (трассировка) — полный путь запроса; Span (спан) — одна операция внутри сервиса (имеет время начала и конца). Инструменты: Jaeger, Zipkin, Tempo (Grafana).
TIG-стек (Telegraf, InfluxDB, Chronograf, Kapacitor)
Платформа для сбора, хранения, визуализации и алертинга метрик и логов.
Telegraf — агент для сбора метрик и логов (push-модель). InfluxDB — time-series database для хранения. Chronograf — веб-интерфейс для визуализации и алертинга. Kapacitor — движок для обработки потоковых данных и расширенного алертинга.
InfluxDB использует концепции measurement (таблица), tags (индексируемые поля для фильтрации) и fields (неиндексируемые значения). Язык запросов — Flux или InfluxQL.
Важное различие версий InfluxDB: версия 1.x использует Chronograf и Kapacitor для визуализации и алертинга, а версия 2.x объединяет их функционал в едином веб-интерфейсе, но имеет ограниченную совместимость с Kapacitor.
Алертинг: проектирование эффективных оповещений
Пороги, эскалация, настройка каналов уведомлений.
Главная ошибка алертинга — отправка уведомлений на каждое незначительное изменение. Алерты должны быть значимыми и вести к действию. Используйте пороги срабатывания (например, задержка > 500 мс в течение 5 минут) и эскалацию.
Эскалация (escalation) — это процедура повышения важности алерта, если он не был решен за определенное время. Сначала уведомление приходит в чат, затем на email, затем руководителю или через SMS.
Популярные каналы уведомлений для алертинга: Email (SMTP), Telegram (бот + chat ID), Slack, PagerDuty, SMS (через шлюз или GSM-модем), Webhook (для интеграции с произвольными системами).
Отказоустойчивость Prometheus и долгосрочное хранение метрик
Проблемы горизонтального масштабирования и решения: Thanos, VictoriaMetrics, Mimir.
Стандартный Prometheus не обеспечивает отказоустойчивость и долгосрочное хранение (long-term storage) из коробки. Федерация (federation) решает проблему частично, создавая единую точку отказа и дублирование данных.
Alertmanager в Prometheus отвечает за группировку, дедупликацию и маршрутизацию алертов. Он может работать в режиме кластера для обеспечения высокой доступности через протокол Gossip.
PromQL: язык запросов Prometheus
Типы метрик, векторы, функции и операторы агрегации.
Типы метрик Prometheus: Counter (только увеличивается), Gauge (может увеличиваться и уменьшаться), Histogram (распределение по корзинам) и Summary (квантили).
В PromQL используются векторы: мгновенный вектор (instant vector) — значения метрик в один момент времени, и диапазонный вектор (range vector) — значения за промежуток времени.
Grafana: продвинутое использование
Управление пользователями, провижининг дашбордов, алертинг и аннотации.
В Grafana разграничение доступа строится на организациях (полная изоляция данных) и командах/группах (логическая группировка для назначения прав). Сервисные аккаунты используются для автоматизации и M2M-взаимодействия.
Мониторинг Kubernetes: Prometheus Operator и kube-prometheus-stack
Сбор метрик с кластера, service discovery, экспортеры.
kube-prometheus-stack — это Helm-чарт, который разворачивает в Kubernetes полный стек мониторинга: Prometheus, Alertmanager, Grafana, а также Prometheus Operator и набор экспортеров (kube-state-metrics, node-exporter).
Prometheus Operator вводит кастомные ресурсы (CRD): ServiceMonitor (как собирать метрики с сервиса) и PodMonitor (как собирать метрики с пода). Это декларативный способ настройки сбора метрик.
Распределенный трейсинг: Jaeger и Grafana Tempo
Отслеживание запросов в микросервисах, OpenTelemetry, интеграция с Grafana.
Jaeger — распределенная система трейсинга, созданная в Uber. Написана на Go. Поддерживает протокол OpenTelemetry и интеграцию с Grafana.
Grafana Tempo — высокомасштабируемое хранилище для трейсов, использующее объектное хранилище (S3/GCS). Не требует индексации, что делает его экономичным. Тесно интегрируется с Grafana и Loki.
OpenSearch vs Elasticsearch: выбор платформы для поиска и аналитики
История, лицензирование, различия в функционале.
OpenSearch — форк Elasticsearch и Kibana (версии 7.10), созданный компанией Amazon после изменения лицензии Elastic с Apache 2.0 на SSPL. Развивается сообществом и AWS.
Ключевое отличие: OpenSearch полностью открыт и бесплатен, в то время как у Elasticsearch есть платные функции (машинное обучение, SIEM, интеграция с Active Directory).
Администрирование Linux: Управление системой и службами (systemd)
В этом разделе вы изучите основы управления системой и службами с помощью systemd. Вы узнаете, как проверять статус, запускать, останавливать и перезагружать службы, а также управлять их автозагрузкой.systemd — это система инициализации и менеджер служб для Linux. Команда systemctl используется для управления службами. `systemctl status sshd` показывает статус службы SSH. `systemctl stop sshd` останавливает службу, `systemctl start sshd` — запускает, а `systemctl restart sshd` — перезапускает. Для включения автозапуска службы при загрузке используется `systemctl enable sshd`.
Для полного запрета запуска службы (даже вручную) используется маскирование (mask). Команда `systemctl mask firewalld` создает символическую ссылку на `/dev/null`, делая службу недоступной для запуска. `systemctl unmask firewalld` отменяет маскирование. Просмотреть все активные службы можно командой `systemctl list-units --type=service`, а неудачные — `systemctl --failed`.
Администрирование Linux: Управление журналами (Logging)
В этом разделе вы научитесь работать с системными журналами. Вы узнаете о традиционной системе rsyslog и современной системе journald, а также о том, как читать, фильтровать и анализировать логи для устранения неполадок.Традиционные логи хранятся в каталоге /var/log/. Основные файлы: `messages` (общие сообщения), `secure` (аутентификация и безопасность), `cron` (задания cron). Команда tail -f /var/log/messages отслеживает новые сообщения. rsyslog настраивается через файл `/etc/rsyslog.conf` и каталог `rsyslog.d/`. journald — централизованный двоичный журнал, управляемый командой journalctl.
Для настройки постоянного хранения журналов journald на диске (вместо RAM) необходимо создать каталог /var/log/journal и установить правильные права доступа. Приоритеты сообщений: emerg, alert, crit, err, warning, notice, info, debug. `journalctl -p err` покажет только ошибки. Ротация логов управляется через logrotate.